- Setor
- Treinamento
- Ferramentas
- Pentaho Data Integration, PostgreSQL, MySQL, MariaDB, Docker
- Entregas
- Roteiro passo a passo no GitHub
- Ambiente com os quatro bancos em Docker
- Transformação pronta (.ktr) e dados de exemplo
Desafio
Os dados de uma mesma análise costumam estar espalhados por sistemas de fornecedores diferentes. O cadastro de funcionários fica no sistema de gestão de pessoas, as vendas ficam em outro sistema, e a divisão das equipes muitas vezes está numa planilha mantida pela gestão. Para saber quanto cada equipe vendeu no mês, alguém precisa juntar as três fontes, e em muitas empresas isso ainda é feito à mão.
O workshop mostra em 40 minutos como um pipeline resolve isso: extrai os dados das três fontes, padroniza e carrega o resultado num Data Warehouse. O mesmo exemplo serve para explicar a diferença entre ETL e ELT, e dá para rodar tudo no próprio computador.
Solução
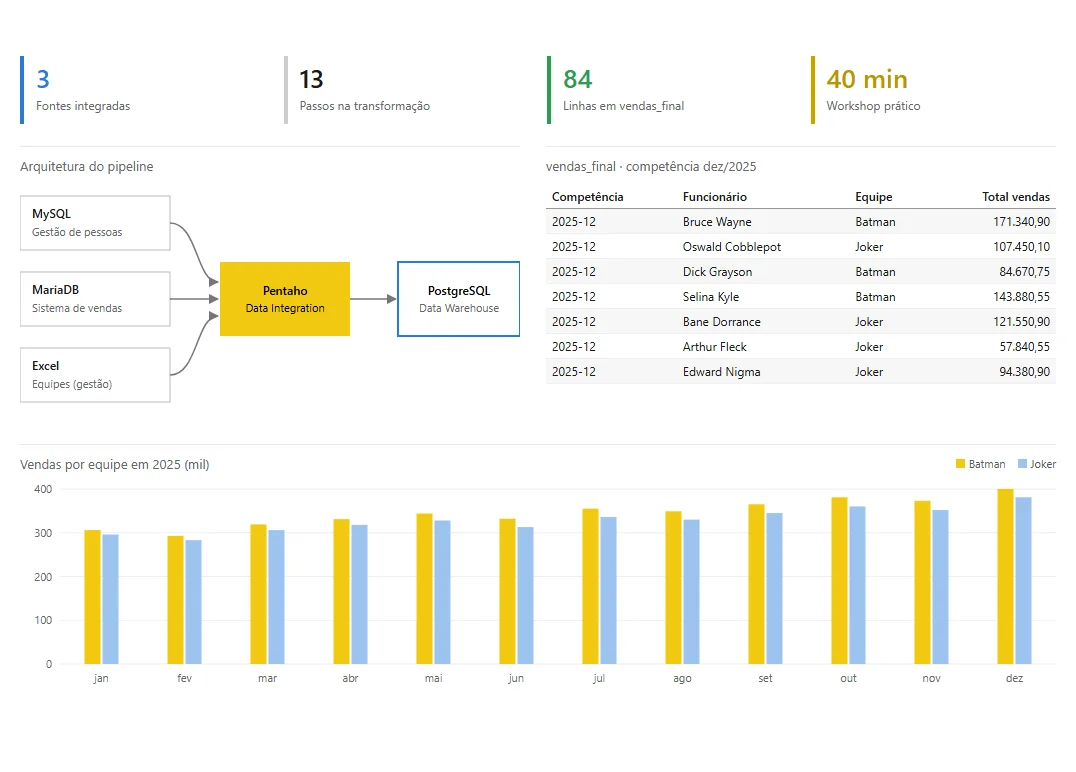
O ambiente simula três sistemas de origem e um DW, cada banco num contêiner Docker:
- MySQL faz o papel do fornecedor 1, o sistema de gestão de pessoas, com a tabela
funcionarios(id, nome e CPF). - MariaDB é o fornecedor 2, o sistema de vendas, com o total vendido por CPF em cada mês de 2025.
- Excel traz a planilha da gestão com a equipe de cada funcionário.
- PostgreSQL é o Data Warehouse que recebe o resultado.
Os nomes e documentos são de personagens do Batman, para que o material possa ser público sem expor dado de ninguém.
A transformação no Pentaho Data Integration tem 13 passos:
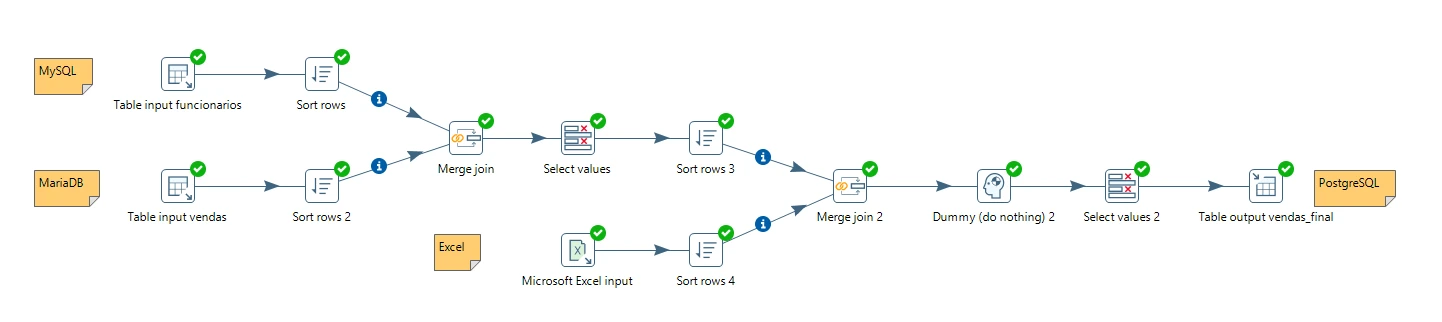
- Dois passos Table input leem
funcionariosno MySQL evendasno MariaDB. - Cada fluxo é ordenado pela chave da junção, porque o Merge join do Pentaho exige as duas entradas ordenadas.
- O primeiro Merge join liga cada venda ao funcionário pelo CPF (
cpf=documento). A junção é externa à esquerda, para nenhuma venda se perder se o cadastro estiver incompleto. - Um Select values fica só com as colunas necessárias, e o resultado é ordenado pelo id do funcionário.
- O Microsoft Excel input lê a planilha de equipes, que é ordenada e entra no segundo Merge join pelo id.
- Outro Select values renomeia os campos:
dt_mesviracompetenciaefuncionarioviranm_funcionario. - O Table output grava a tabela
vendas_finalno schemapublicdo DW. A tabela é esvaziada antes de cada execução, então toda carga é completa.
O roteiro no GitHub traz os comandos para subir cada banco, os scripts que criam e preenchem as tabelas de origem e a instalação do Pentaho 9.4 com Java 8. A conexão com o MariaDB usa o mesmo conector JDBC do MySQL, que vai junto no repositório.
Resultado
- A tabela
vendas_finalno DW, com 84 linhas: competência, funcionário, equipe e total de vendas dos 7 funcionários nos 12 meses de 2025. - Com a tabela pronta, saber quanto cada equipe vendeu passa a ser uma consulta simples. No exemplo, as duas equipes somaram cerca de R$ 8,1 milhões no ano: R$ 4,15 milhões a equipe Batman e R$ 3,95 milhões a Joker.
- Um ambiente que qualquer pessoa reproduz em poucos minutos com Docker, para praticar extração, junção de fontes e carga num DW.
A diferença entre ETL e ELT, com este mesmo pipeline reescrito em SQL dentro do PostgreSQL, está no artigo ETL e ELT na prática: o mesmo pipeline feito dos dois jeitos.
Workshop preparado pelo fundador da Dome Analytics, com dados fictícios. O material completo está no GitHub.
Projetos relacionados
Modernização da Engenharia de Dados de um Hospital
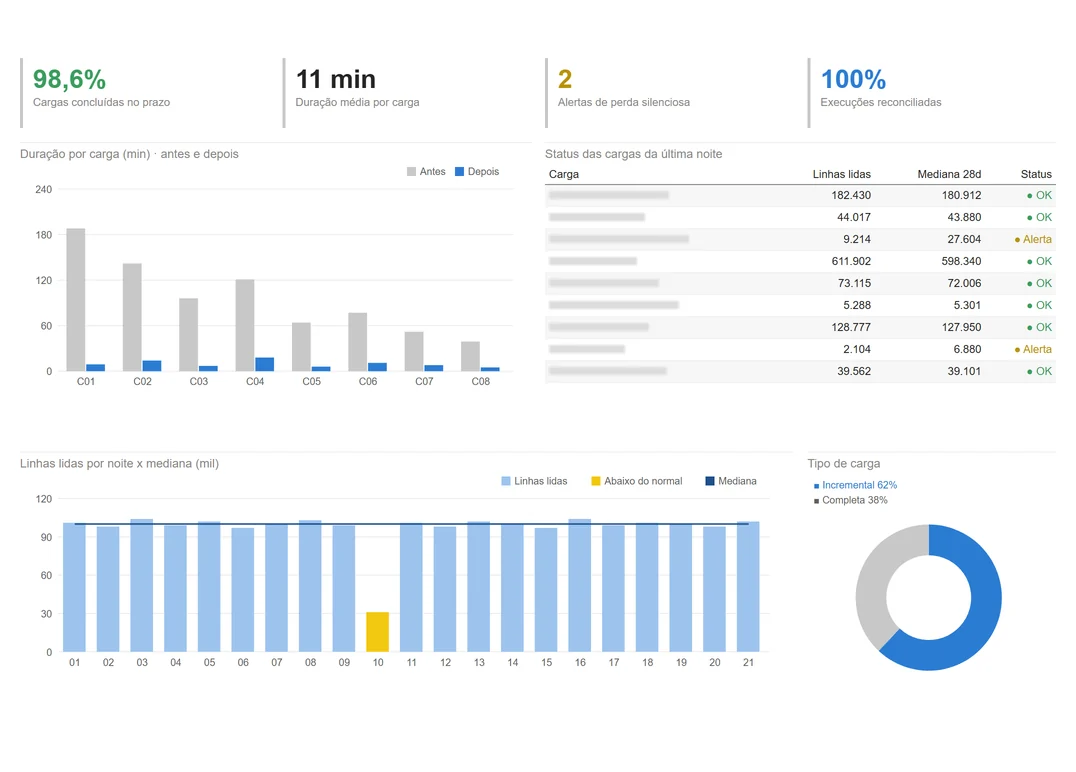
Diagnóstico medido e correção das cargas noturnas de um hospital de grande porte, com reconciliação a cada execução e alerta de perda silenciosa.
Dashboard de Resultados Financeiros
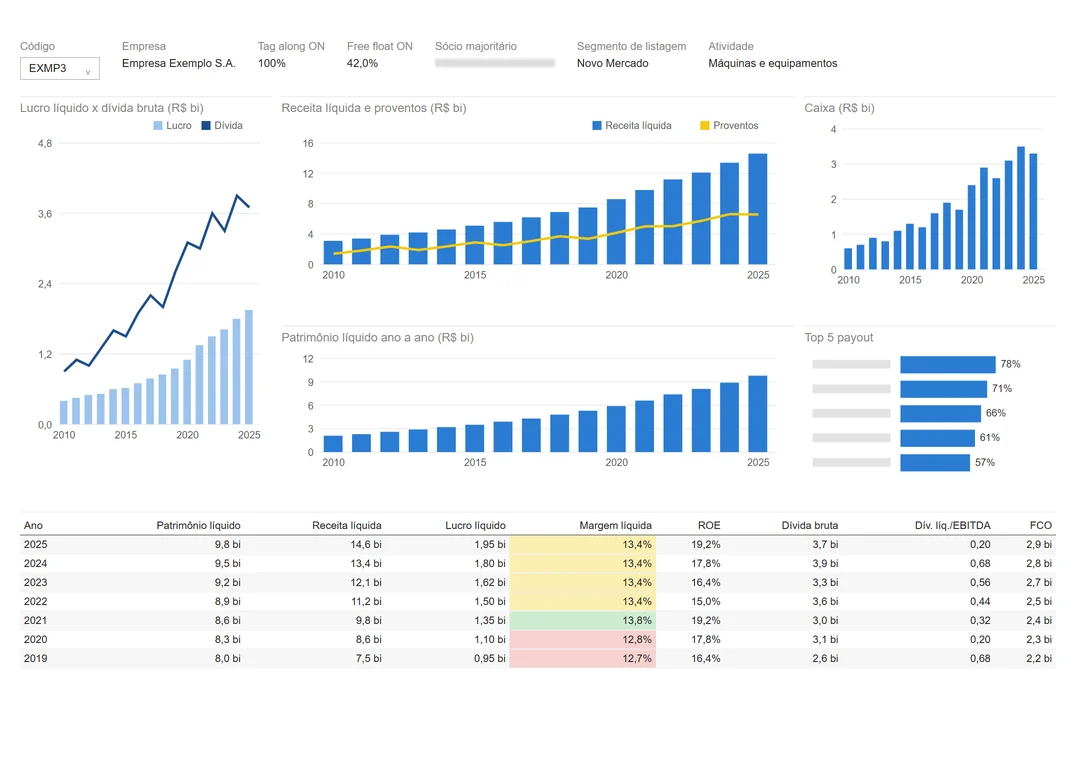
Projeto de estudo com dez anos de resultados financeiros das blue chips da B3, empresa a empresa e com comparação entre setores.