- Setor
- Mobilidade urbana
- Ferramentas
- Python, Apache Kafka, Apache Spark, PostgreSQL, DuckDB, Docker
- Entregas
- Coleta de um dia inteiro do feed, a cada 15 segundos
- Tópico no Kafka com produtor ao vivo e replay
- Três jobs de Spark Structured Streaming conferidos contra um cálculo em lote
- Gravação no PostgreSQL que não duplica quando um job cai
- Painel interativo em HTML, com mapas
Desafio
A Prefeitura do Rio publica como dados abertos a posição de cada ônibus e de cada veículo do BRT em viagem, no padrão GTFS-Realtime, atualizada a cada 30 segundos. O GTFS publicado junto traz as linhas, os traçados e o intervalo planejado entre as partidas. Com os dois dá para responder perguntas de quem pega ônibus no Rio: onde o trânsito trava, quanto tempo os veículos ficam parados longe do terminal e se a linha passa no intervalo prometido.
O feed não entrega essas respostas prontas. Ele não diz quando o ônibus saiu do ponto inicial: a Prefeitura encaixa cada veículo num horário da grade planejada, e no dia coletado 4.526 desses horários apareceram com dois ou mais ônibus. A posição chega com 33 segundos de atraso na mediana, metade das linhas repete a consulta anterior, e há saltos que exigiriam mais de 120 km/h e posições fora do município.
Este projeto de estudo trata o feed como um fluxo. As posições passam por um tópico do Kafka, três jobs de Spark Structured Streaming calculam velocidade, paradas e viagens enquanto os dados chegam, os resultados vão para o PostgreSQL e terminam num painel. Tudo roda em contêineres com Docker Compose.
Solução
Escolha um job do Spark para ver de onde ele lê, como agrupa as posições e o que gravou no dia.
Velocidade média de cada linha a cada 5 minutos
- Entrada
- Posições do tópico com até 5 minutos de idade e no máximo 30 segundos à frente, sem as repetidas
- Agrupamento
- Janela fixa de 5 minutos por modo e linha, no horário da posição (tempo do evento)
- Saída
- Posições, veículos, velocidade média, velocidade em movimento e parte das posições paradas
- Dia 6/11
- 87.137 janelas, todas iguais ao cálculo em lote; a velocidade nunca diferiu mais de 0,0001 km/h
Veículos parados no mesmo lugar
- Entrada
- Posições com velocidade zero, com a latitude e a longitude em 4 casas (cerca de 11 metros)
- Agrupamento
- Sessão por veículo e ponto enquanto o intervalo entre posições for de até 5 minutos (session_window)
- Saída
- Paradas de 5 minutos ou mais, com a linha, a viagem e a distância ao terminal mais próximo da linha
- Dia 6/11
- 2.555 paradas; 193 de 15 minutos ou mais e só 82 perto de um terminal
Viagens de cada veículo
- Entrada
- Posições com linha e sentido, mais os pontos inicial e final de cada sentido, tirados do GTFS
- Agrupamento
- Sessão por veículo, linha e sentido enquanto o intervalo entre posições for de até 10 minutos
- Saída
- Viagens de 20 minutos ou mais, com duração, velocidade e distância da primeira posição ao ponto inicial
- Dia 6/11
- 42.700 viagens; 74% das de ônibus e 82% das do BRT começaram a até 1 km do início, e delas sai o intervalo real
- Coleta. Um coletor em Python consultou os dois feeds a cada 15 segundos durante a sexta-feira, 6 de novembro de 2026, das 0h às 23h05, sem nenhuma falha. Guardou cada resposta e uma tabela Parquet a cada 5 minutos: 11,3 milhões de linhas de ônibus e 1,3 milhão do BRT. Esse dia guardado é a base do replay e da conferência dos jobs.
- Kafka. O Kafka roda num contêiner em modo KRaft, sem ZooKeeper. O produtor publica uma mensagem JSON por veículo em cada consulta, ao vivo ou reenviando um dia guardado. A chave da mensagem é o modo e o veículo, então as posições de um veículo ficam sempre na mesma partição e chegam em ordem. O replay do dia inteiro pôs 11.698.813 mensagens no tópico em 366 segundos.
- Spark. Os três jobs leem o mesmo tópico. Antes de agrupar, descartam posições adiantadas mais de 30 segundos ou com mais de 5 minutos de idade e removem as repetidas. A marca d'água é de 6 minutos: a maior idade aceita mais os 30 segundos de folga. Cada resultado é gravado uma vez só, quando a marca d'água passa do fim dele.
A janela fixa corta o tempo em blocos de 5 minutos iguais para todas as linhas. Cada bloco vira uma linha na tabela de velocidade, com a média das posições que caíram nele. Um bloco sem posição não gera linha.
A sessão não tem tamanho fixo. Ela começa na primeira posição parada e continua enquanto a próxima vier em até 5 minutos, no mesmo ponto. A parada só fica se durar 5 minutos ou mais.
Na viagem, a sessão aceita até 10 minutos entre uma posição e outra. Um buraco maior no feed fecha a viagem, e a próxima posição abre outra. Viagens com menos de 20 minutos costumam ser troca de sentido no terminal e ficam de fora.
A marca d'água é o maior horário de posição já visto menos 6 minutos. O que termina antes dela já pode ser gravado, porque nenhuma posição válida chega tão atrasada. O resto fica guardado no estado do Spark, e o checkpoint permite continuar de onde parou depois de uma queda.
- Conferência. Cada job foi refeito em lote com DuckDB a partir dos Parquet da coleta e comparado resultado a resultado com a saída do Spark. A comparação achou duas diferenças de regra. O Spark junta na mesma sessão duas posições que estão exatamente 5 minutos uma da outra, e o lote passou a quebrar a sessão só acima disso. Com o ônibus parado, o feed às vezes troca a viagem atribuída e volta minutos depois. Com a viagem na chave da parada, uma parada longa virava vários pedaços, e a viagem saiu da chave. Depois dos ajustes, os três jobs chegaram exatamente aos mesmos resultados do lote no dia inteiro.
- PostgreSQL sem duplicar. Com a opção de banco, cada lote do Spark vai para uma tabela temporária, entra na tabela final com
INSERT ... ON CONFLICT DO UPDATEna chave do resultado e fica registrado numa tabela de lotes, tudo numa transação. Se o job cair depois de gravar e antes de confirmar o lote no checkpoint, ele refaz o mesmo lote ao voltar, e a chave faz as linhas repetidas sobrescreverem as que já estavam lá. Quatro testes de falha conferiram esse caminho:
O job de viagens morreu logo depois de gravar o lote 20 no banco. O checkpoint tinha o lote 20 planejado e só o 19 confirmado. Na execução seguinte, o Spark refez o lote 20 com as mesmas 775 linhas, e o banco continuou igual à saída em Parquet.
Com o contêiner do job de paradas morto logo depois do lote 25, a nova execução continuou do lote 26 e o resultado final ficou igual.
Com o PostgreSQL parado depois do lote 15 do job de velocidade, o lote 16 falhou ao conectar e o job terminou com erro, sem confirmar o lote. Com o banco de volta, a nova execução começou pelo lote 16 e o resultado final ficou igual.
Com o Kafka reiniciado durante o lote 10 do job de viagens, o Spark registrou avisos de conexão por alguns segundos e seguiu sozinho até o lote 59. O tópico manteve as 11.698.813 mensagens e o banco ficou igual à saída em Parquet.
- Intervalo real. O intervalo entre partidas fica fora do streaming de propósito. Ele depende da partida anterior da mesma linha, e as viagens saem do Spark só quando terminam, fora da ordem de partida. Um script com DuckDB conta como partida a viagem cuja primeira posição apareceu a até 1 km do ponto inicial, calcula o intervalo com uma função de janela e compara com o planejado no GTFS, no tipo de dia certo (dia útil, sábado, domingo ou feriado).
- Painel. Um script em Python lê as tabelas do PostgreSQL, agrega com DuckDB e grava um arquivo HTML com os dados embutidos. O painel é HTML, CSS e JavaScript, sem biblioteca. Os mapas são desenhados a partir da malha do município do IBGE e dos traçados do BRT no GTFS, sem mapa de fundo de terceiros. São quatro páginas (visão geral, velocidade, regularidade e paradas) com filtros de modo, linha e hora que valem para todas, gráficos que filtram ao clique e um botão Documentação que percorre cada visual. O painel abaixo é o mesmo do botão Ver projeto:
Resultado
- Frota: de 200 ônibus às 2h a quase 3.600 nos picos das 7h às 8h e das 17h às 18h.
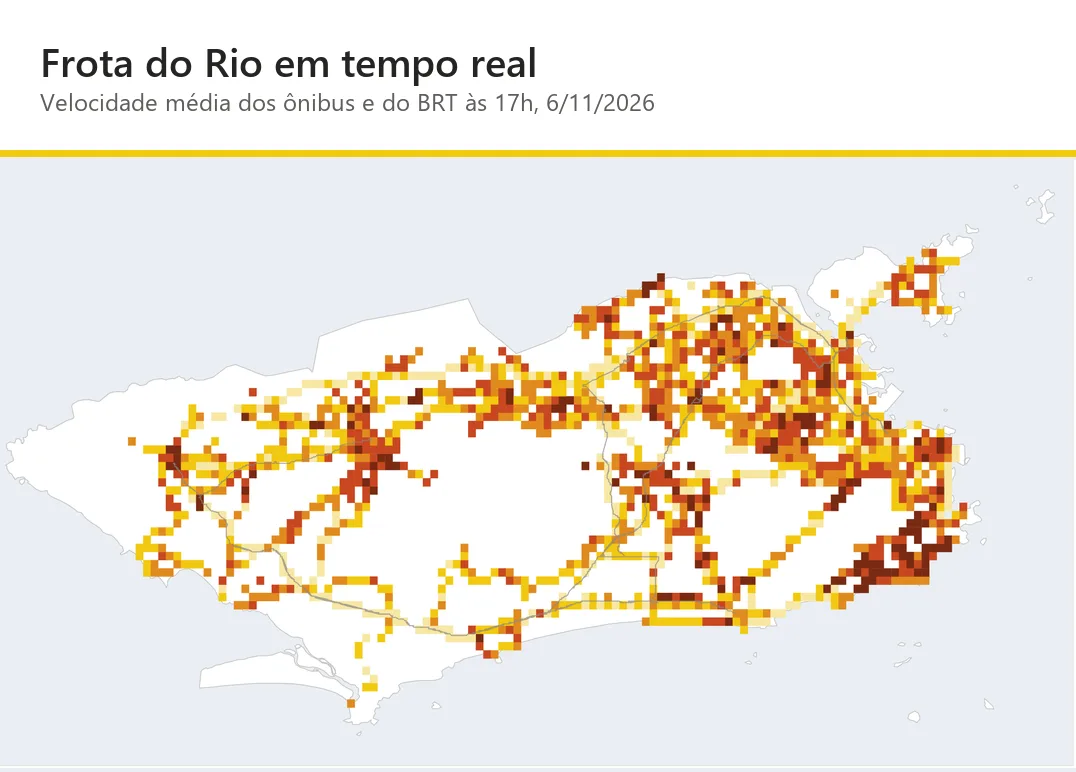
- Velocidade: os ônibus caem de 34 km/h de madrugada para 15 km/h às 17h. O BRT, que roda em corredor próprio, fica entre 28 e 31 km/h das 6h às 23h. No mapa dos ônibus, os quadrados de cerca de 550 m com média abaixo de 10 km/h passam de 37 às 8h para 154 às 17h.
- Paradas: 2.555 vezes um veículo ficou parado no mesmo lugar por 5 minutos ou mais. 193 paradas passaram de 15 minutos, a maior de ônibus com 126 minutos e a maior do BRT com 62. Só 82 das 2.555 estavam perto do início ou do fim da linha.
- Partidas: das 5h às 20h, o pipeline encontrou de 68% a 72% das partidas de ônibus previstas no GTFS e de 55% a 61% das do BRT. A diferença junta viagens que o feed começou a mostrar longe do ponto inicial e viagens que não aconteceram, e os dados não separam as duas.
- Intervalo real: nos ônibus, o intervalo mediano entre as partidas encontradas foi de 13,8 minutos para 12,0 planejados; no BRT, de 7,6 para 6,0. Saíram em comboio, abaixo de um quarto do planejado, 5,5% dos intervalos de ônibus e 3,7% dos do BRT. Na linha SP864, planejada a cada 4 minutos das 6h às 20h, o intervalo mediano foi de 4,0 minutos, mas 10% passaram de 9,2 minutos e 22% ficaram abaixo de 1 minuto.
- Engenharia: os três jobs chegaram aos mesmos resultados do cálculo em lote no dia inteiro, e os quatro testes de falha terminaram com o banco igual à saída em Parquet, sem linha perdida nem duplicada.
Os números têm limites que o painel também mostra. O GTFS público é de junho de 2026, e o feed usa uma programação mais nova em parte das linhas. Cada partida que o pipeline não encontra junta dois intervalos num só, então a parte de intervalos acima do dobro do planejado sai inflada. Os dois feeds em tempo real ainda estão em versão beta.
O botão Ver projeto abre o painel em tela cheia. O código está no GitHub, com a licença MIT e as instruções para subir Kafka, Spark e PostgreSQL com Docker e repetir o dia 6 de novembro pelo replay.
Projeto de estudo da Dome Analytics com dados abertos da Prefeitura do Rio de Janeiro, sob a licença CC BY 4.0. Não tem relação com a Prefeitura, com as empresas de ônibus nem com o BRT.
Projetos relacionados
Internações do SUS em Pernambuco, dos Arquivos do DATASUS a um Painel
Pipeline com Spark e dbt que leva os arquivos públicos de internações do SUS a um modelo testado e a um painel com as 666 mil internações de 2024 em Pernambuco.
Cortes de Geração Eólica e Solar, dos Dados do ONS a um Painel em Power BI
Dados abertos do ONS num pipeline com Airflow e dbt e num painel em Power BI: 88 mil GWh que eólicas e solares deixaram de gerar por ordem do operador desde 2021.